Ignorar el largo del texto infla los falsos positivos al contar palabras
Un preprint que pone a prueba 126 métodos estadísticos en nueve conjuntos de textos muestra que la forma más habitual de comparar frecuencias de palabras entre grupos falla cuando un grupo escribe más que otro.
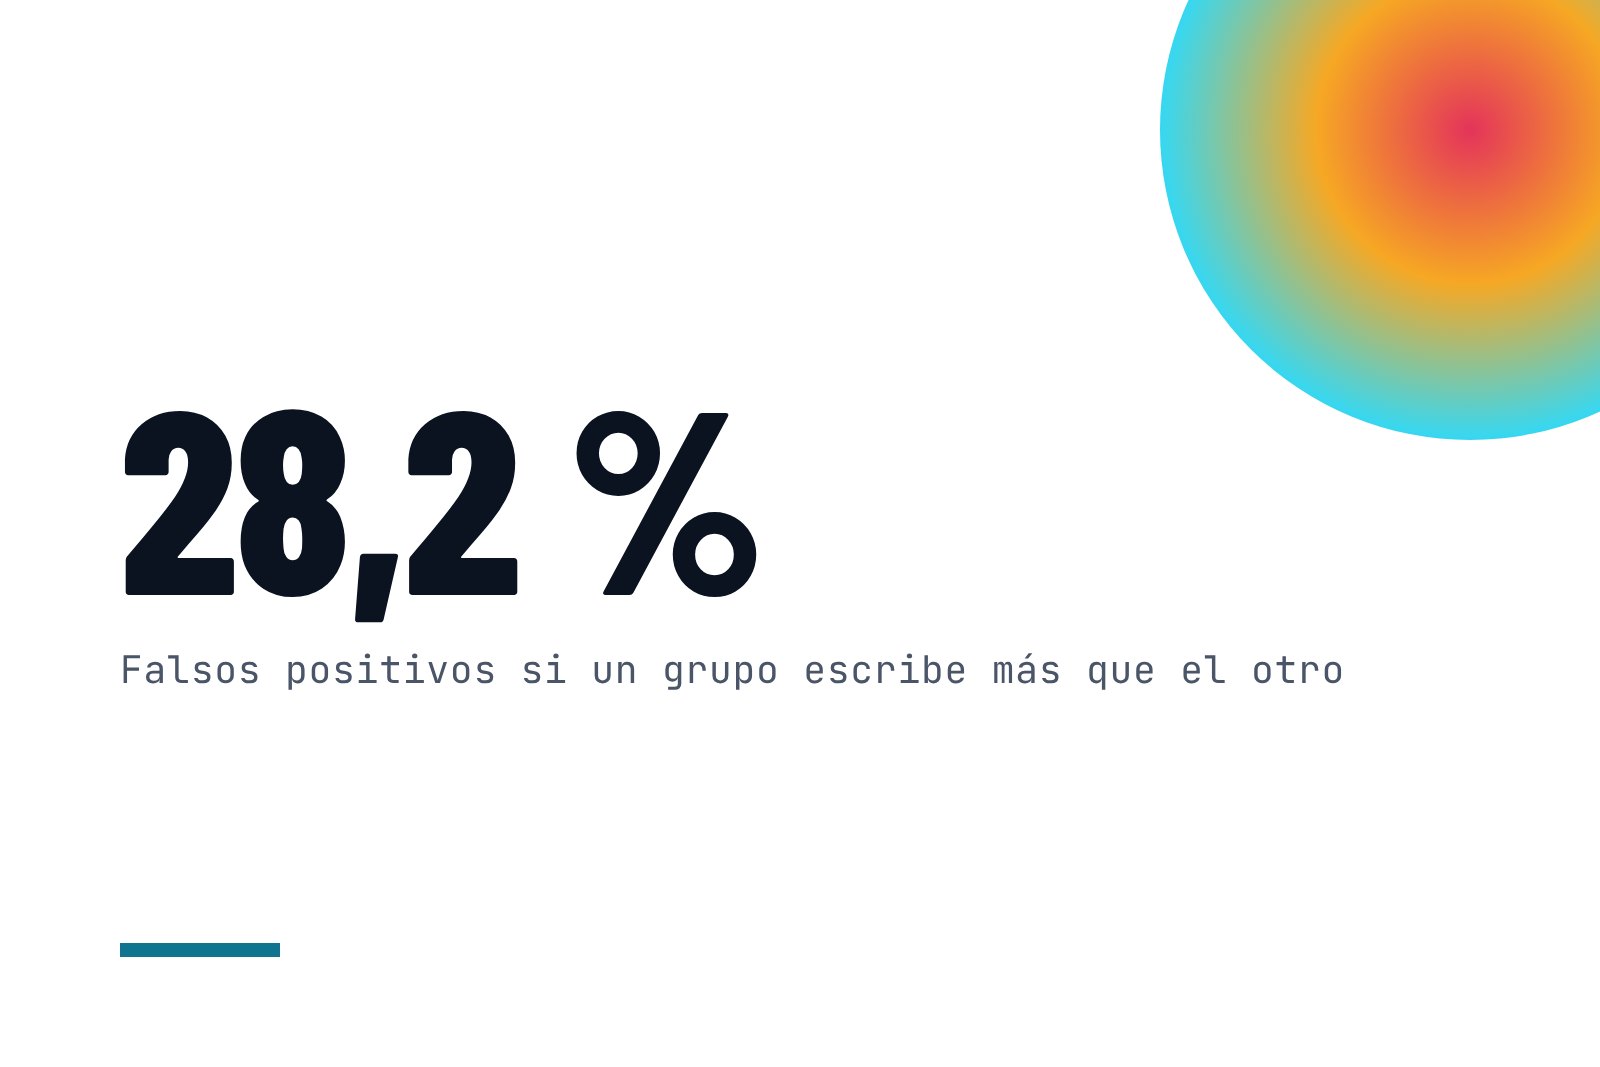
Una de las técnicas más usadas para analizar texto consiste en calcular qué proporción de sus palabras pertenece a un diccionario, como el de emociones positivas, y comparar ese porcentaje entre dos grupos. Un preprint de Louis Teitelbaum y Almog Simchon, de la Universidad Ben-Gurión del Néguev, publicado en PsyArXiv y todavía sin revisión por pares, encuentra que esa práctica produce resultados falsos cuando los grupos difieren en cuánto escriben. En sus simulaciones, los grupos se asignaron al azar y no tenían ninguna diferencia real. Aun así, cuando la pertenencia al grupo se asociaba con el largo del texto (r = 0,6), la regresión lineal sobre frecuencias relativas dio un resultado significativo en el 28,2 % de los casos. El margen aceptado es del 5 %.
Un cociente que no controla lo que promete
La práctica que se cuestiona es la que promueven herramientas como LIWC: contar las palabras del diccionario, dividirlas por el total de palabras y usar ese porcentaje como variable en una regresión, una prueba t o un ANOVA. Dividir por el largo parece neutralizarlo, pero eso solo funciona si la proporción de palabras de un tema no cambia con la extensión del texto. Los autores sostienen que esa condición rara vez se cumple, porque un texto largo puede tocar más temas, cambiar de registro o venir de otro tipo de autor. La advertencia no es nueva: en 1993, Kronmal ya había mostrado que usar cocientes en una regresión invita a correlaciones espurias.
El trabajo distingue tres fuentes de error. La primera es suponer una distribución equivocada: las cuentas de palabras varían más de lo que admite la regresión de Poisson. La segunda es controlar mal el largo. La tercera es más sutil: en un texto breve, la frecuencia de las palabras presentes tiende a sobrestimarse, porque no hay espacio para que aparezcan las que no se usaron.
Cómo lo pusieron a prueba
Los autores reunieron nueve conjuntos de textos de naturaleza muy distinta. Hay tuits, publicaciones de Facebook, diálogos transcritos y relatos autobiográficos de personas de 37 países, además de textos académicos y de ficción del Corpus of Contemporary American English y dos colecciones de posteos de Reddit. Midieron seis listas del diccionario LIWC-22 (emoción positiva, emoción negativa, tristeza, enojo y pronombres de primera persona del singular y del plural) y, con la biblioteca spaCy, los verbos auxiliares de la voz pasiva.
Combinaron siete familias de modelos, siete formas de incluir el largo del texto y tres maneras de estimar las frecuencias, para un total de 126 métodos. Cada uno se aplicó 500 veces a muestras de 500 y 1.000 textos, en tres escenarios en los que cualquier resultado significativo era, por construcción, un falso positivo. En el primero, los grupos se mezclaron al azar; en el segundo, se asignaron al azar pero asociados con el largo; en el tercero, la mitad de los textos se recortó a la mitad de su extensión. Además, simularon datos a partir de modelos con un efecto conocido, para medir sesgos y precisión.
Dónde falla el método habitual
Cuando el grupo no tenía relación con el largo, casi todos los métodos se comportaron bien. La regresión lineal sobre frecuencias relativas, probablemente la más común en psicología, tuvo una tasa de falsos positivos de 0,048. Las excepciones fueron la regresión de Poisson y la binomial, que dieron entre 0,23 y 0,33 porque no admiten la variabilidad extra de las cuentas de palabras.
El problema central apareció al asociar el grupo con el largo. La misma regresión lineal pasó de 0,050 sin asociación a 0,080 con una correlación de 0,2, a 0,167 con 0,4 y a 0,282 con 0,6. Como referencia, la mayor correlación entre una variable de grupo y el largo en los datos reales del estudio fue de 0,17. Solo 27 de los 126 métodos se mantuvieron dentro del margen en todos los niveles, y todos incluían el logaritmo del largo o una curva flexible sobre él.
Las soluciones más accesibles no alcanzaron. Los errores estándar robustos corrigieron el exceso de variabilidad, pero no el sesgo por largo: con una correlación de 0,6, la tasa siguió entre 0,287 y 0,300. El suavizado de Laplace, que suma uno a cada cuenta, lo empeoró: en los modelos sin otro control del largo, la tasa llegó a 0,91. Recortar los textos fue lo peor: todos los métodos dieron falsos positivos en exceso en al menos seis de las 18 combinaciones de datos y diccionario analizadas, porque cortar un texto cambia también su contenido.
Solidez y transparencia
Es un estudio de simulación, no preregistrado, que usa datos públicos y comparte código y resultados. Su fortaleza es la variedad: textos de 10 a más de 5.000 palabras en promedio, constructos emocionales y lingüísticos, y un segundo frente con datos generados a partir de modelos conocidos. En los textos reales, la mediana de la elasticidad fue de −0,15, es decir, los constructos tendieron a usarse con menos frecuencia en los textos más largos. Con una elasticidad de −0,35 y una correlación de 0,6 en los datos simulados, la regresión lineal sobre frecuencias relativas llegó a 0,71 de falsos positivos.
Los autores informan que usaron un modelo de lenguaje para optimizar el código, desarrollar parte de las simulaciones y redactar secciones de métodos y resultados. Lo hicieron con supervisión del primer autor, pero sin una validación independiente de esas salidas. Según su propia revisión, solo un estudio previo, el de Massell, Lieb, Meyer y Mayor sobre estados psicológicos en Twitter durante la pandemia, incluyó el logaritmo del largo como covariable.
Qué cambia para la investigación de mercados
El conteo de palabras es una herramienta habitual para analizar reseñas, menciones en redes y respuestas abiertas de encuestas. En esos materiales, los grupos que se comparan pueden escribir con extensiones distintas: dos plataformas con límites de caracteres diferentes, dos comunidades con hábitos propios o dos segmentos de clientes que se explayan de forma desigual. Según este trabajo, una diferencia en el porcentaje de palabras positivas entre esos grupos puede reflejar solo que uno escribe más.
La recomendación de los autores es concreta. Proponen no analizar frecuencias relativas sin un control adicional del largo e incluir el logaritmo de la cantidad total de palabras como covariable. También, usar un modelo que admita variabilidad extra, como la regresión de Poisson-lognormal, cuya tasa más alta de falsos positivos fue de 0,042. Una alternativa más simple es la regresión lineal con una curva flexible sobre el logaritmo del largo. Y advierten contra comparar textos completos con fragmentos o con textos recortados por una plataforma, porque ninguna corrección estadística recupera esa comparación.
Los límites
Casi todas las simulaciones compararon variables de dos categorías, y el modelo con efecto conocido supone que la relación con el largo sigue una forma logarítmica, que es justo la que corrige la solución propuesta. Otros patrones podrían aparecer en textos reales. Los autores presentan sus recomendaciones como la opción menos mala, no como una garantía: cuando el largo difiere mucho entre los grupos, y sobre todo cuando eso implica diferencias de contenido, ningún ajuste asegura una comparación válida.