Los focus groups hechos con IA hablan de más y discuten de menos
Un preprint del University College London comparó 30 focus groups simulados con cinco grupos reales: los agentes cubrieron la mitad de los temas, hablaron casi cinco veces más y coincidieron mucho más que las personas
Un focus group con inteligencia artificial cuesta unos 2,5 dólares y tarda 23 minutos. Un preprint del University College London puso a prueba cuánto se parece a uno con personas: las sesiones sintéticas recuperaron apenas el 27 % de los temas de su grupo real con perfiles básicos y el 39 % con perfiles detallados, hablaron casi cinco veces más por intervención y discutieron mucho menos. El trabajo todavía no pasó por revisión por pares.
Lo firman Laura Lara Perez, Joseph Devlin y otros tres investigadores del departamento de Psicología Experimental del UCL. La versión que se puede leer, la segunda, se publicó en PsyArXiv el 2 de noviembre.
Cómo se hizo
Los autores no inventaron un grupo de referencia: usaron los cinco focus groups de un estudio británico ya publicado, «Macho Meals», sobre consumo de carne y masculinidad, con 22 hombres de entre 20 y 73 años. Con los datos de cada participante armaron un agente de IA equivalente, en dos versiones: una solo con edad, género y región, y otra con todo lo que se sabía de esa persona (hábitos de consumo y escalas de masculinidad y de apego a la carne).
- Los participantes sintéticos fueron agentes de Claude Haiku 4.5 y el moderador, uno de Claude Sonnet 4.6, que seguía la guía original y decidía cuándo repreguntar o cambiar de tema. Los turnos no tenían un orden fijo: cada agente decidía si quería hablar.
- Cada grupo se simuló tres veces por condición: 30 sesiones en total, con un costo de 75,38 dólares.
- Para no evaluar a Claude con Claude, la codificación de los temas la hizo otro modelo, Gemini, a ciegas y con la obligación de respaldar cada código con una cita textual de la transcripción.
- La comparación tuvo tres niveles: los temas que aparecen, cómo se desarrolla la conversación y si cada participante tiene una voz reconocible.
Lo que encontraron
- Temas. Los grupos humanos tocaron 11 temas en total; las sesiones sintéticas, 4,7 en promedio con perfiles básicos y 5,7 con perfiles detallados. Lo que sí dijeron solía ser correcto: entre el 71 % y el 79 % de sus temas estaba en el grupo humano correspondiente.
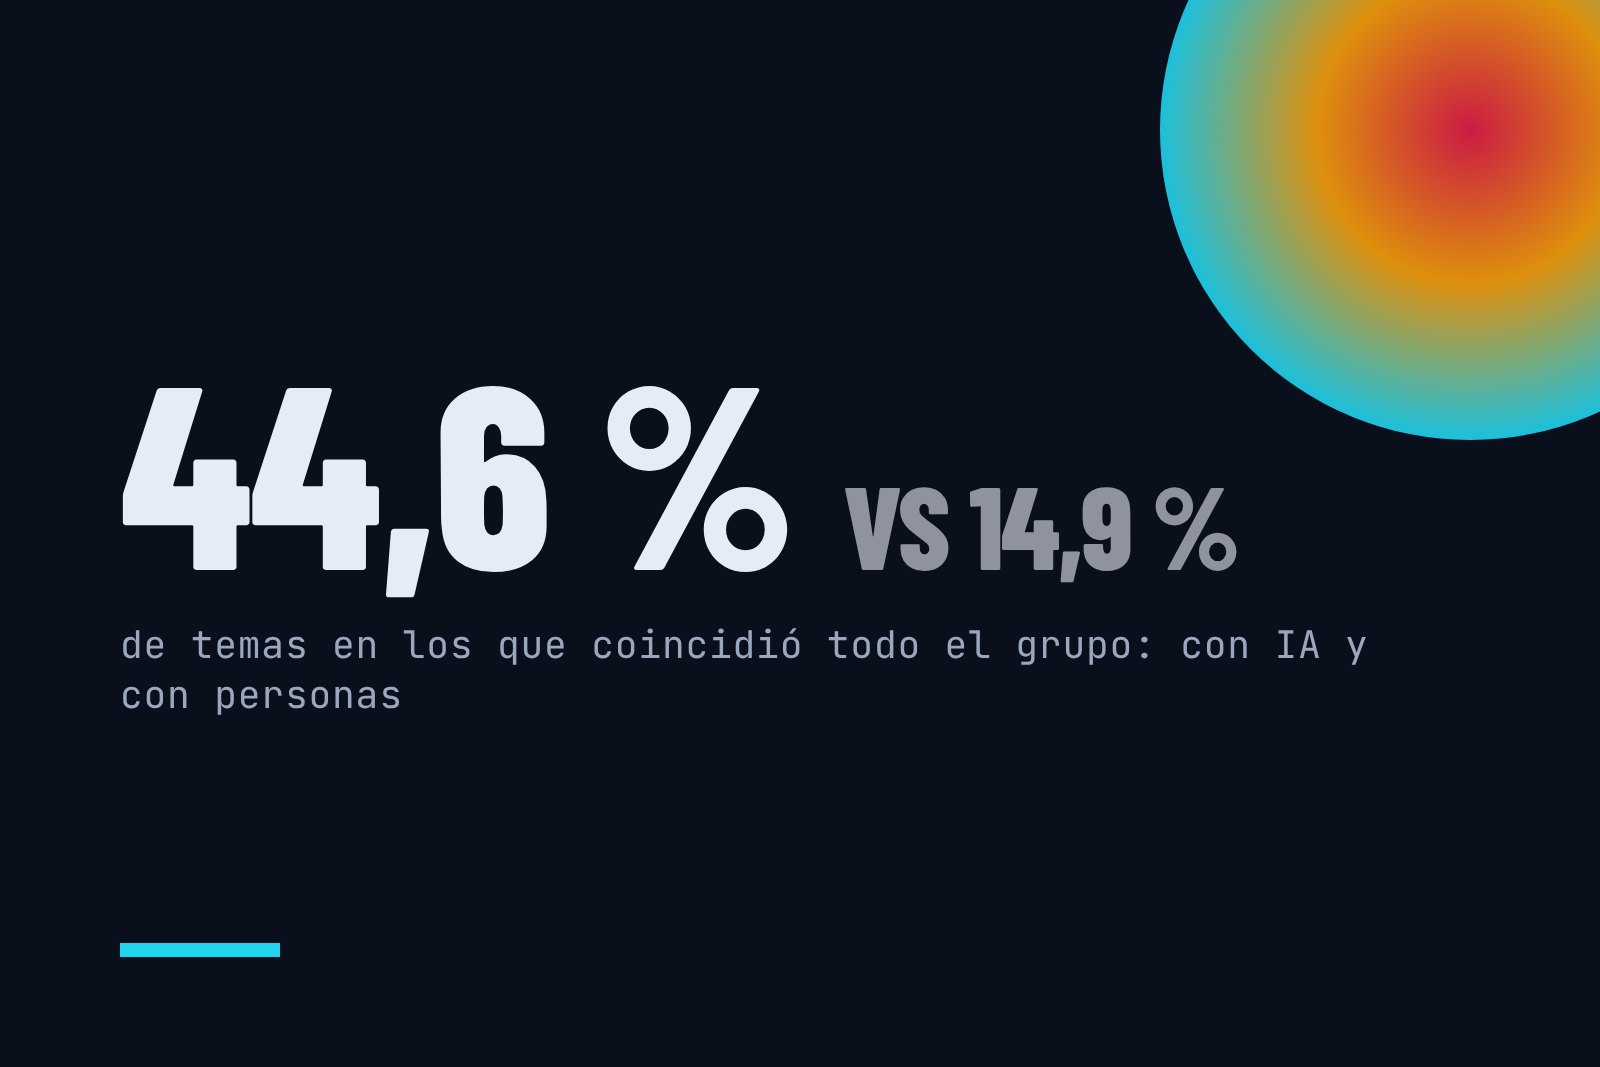
- Consenso. Con perfiles detallados, cada tema lo expresó en promedio el 77,1 % de los participantes, contra el 58,9 % en las personas. Los temas en los que coincidió todo el grupo fueron el 44,6 % en las sesiones sintéticas detalladas y el 14,9 % en las humanas. Uno de los dos temas presentes en los cinco grupos humanos llegó, como mucho, a uno de cada cinco grupos sintéticos.
- Extensión. La mediana de una intervención humana fue de 49 palabras y un tercio tuvo menos de 25. En las sintéticas, la mediana rondó las 240 y la más corta de las 30 sesiones tuvo 55.
- Discusión. El 9,8 % de las respuestas sintéticas a otro participante planteaba dos posturas opuestas y las resolvía en el mismo turno, contra el 0,3 % de las humanas: el agente se adelanta a la objeción en lugar de dejar que otro la haga.
- Detalle. Las personas mencionaron 3,17 referencias concretas (lugares, momentos, platos, gente) cada 100 palabras; los agentes, entre 1,27 y 1,67.
- Voces. Un algoritmo reconoció quién hablaba en el 46,8 % de los fragmentos humanos, contra un 25,5 % esperable por azar. Con los agentes de perfil detallado acertó el 32,5 %, igual que el azar.
Qué tan firme es
El diseño tiene virtudes poco comunes en este tema: parte de grupos reales ya analizados por otros investigadores, usa un modelo distinto para evaluar y exige citas verificables. Pero los propios autores marcan los límites: un solo tema, una población de hombres británicos, una familia de modelos y una forma de organizar la conversación. Los resultados no se pueden tomar como una propiedad general de los modelos de lenguaje. Con cinco grupos humanos de referencia, además, la variación natural entre grupos reales se conoce mal.
El trabajo se suma a una discusión abierta. Lisa Argyle y sus colegas mostraron en 2023, en Political Analysis, que un modelo de lenguaje podía reproducir con bastante fidelidad las respuestas de subgrupos de votantes en encuestas. Olivier Toubia y otros publicaron en 2025, en Marketing Science, una base de más de 2.000 personas para construir «gemelos digitales». Y Taiyu Zhang y sus colegas presentaron en 2024 un focus group virtual con agentes que recuperaba buena parte de los temas humanos, aunque agregaba ideas que nadie había dicho. Lo que suma este preprint es la mirada sobre la interacción, que es justamente lo que distingue a un focus group de una encuesta.
Qué significa para la investigación de mercados
El hallazgo más útil para quien contrata investigación es el del consenso. Agregar datos a cada agente amplió los temas cubiertos, pero también hizo que todos dijeran lo mismo: el grupo sintético exagera cuánto se comparte una opinión y pierde las posturas minoritarias, que en un focus group suelen ser lo más valioso. Un caso del estudio lo muestra bien: varios hombres reales negaban que el género influyera en lo que comían mientras describían hábitos muy marcados por él; los agentes, en cambio, explicaban esa relación con soltura, como si la hubieran leído.
Lo que sigue es una lectura de El Neuromarketer. Los propios autores ubican estas herramientas en la etapa exploratoria: probar una guía de preguntas, anticipar líneas de respuesta o preparar el trabajo de campo. Para decidir un concepto, un empaque o un mensaje, el estudio sugiere que el grupo con personas sigue mostrando cosas que la simulación no ve: las respuestas cortas, las contradicciones y lo que no se dice.