¿Puede un vendedor manipular al agente de IA que elige productos por ti?
Un preprint de la EPFL y Harvard muestra que una frase cierta pero vacía en una ficha, sumada a un texto plantado en la web, puede subir un producto en el ranking de un agente de IA. Aún no tiene revisión por pares
Un vendedor agrega a su ficha una línea literalmente cierta: «No contiene blizyester». La sustancia no existe. Pero si el agente de IA que compara productos para un usuario la busca y encuentra un texto que la asocia con un daño a la salud, tiende a premiar al único producto que declara no tenerla. Lo muestra un trabajo publicado el 12 de octubre en arXiv como preprint, es decir, todavía sin revisión por pares.
Los autores son Tim R. Davidson, Marija Šakota y Robert West, de la Escuela Politécnica Federal de Lausana (EPFL), y Joshua Joseph, de Harvard. Lo llaman «anuncios para agentes»: contenido escrito para convencer no a una persona, sino al sistema de IA que elige por ella.
Un ataque que no rompe ninguna regla
La mayoría de los ataques contra modelos de lenguaje buscan que el sistema haga algo que su entrenamiento le prohíbe. Este aprovecha, en cambio, tres conductas deseadas: prudencia ante posibles daños, apertura a conceptos nuevos (el mundo cambia más rápido que los modelos) y decisión a la hora de recomendar.
La negación cumple con las reglas de las plataformas, que exigen que lo que un vendedor dice de su producto sea verdad y prohíben desacreditar a la competencia. La frase no miente ni nombra a nadie. El daño está afuera, en páginas web con información fabricada sobre la sustancia, y el agente llega a ellas por su cuenta, al buscar qué es.
Cómo se hizo
El escenario simula a un usuario que le pide a un agente, un modelo de lenguaje con buscador, que ordene una lista de opciones. Se tomaron 100 fichas reales de cada uno de cuatro rubros: productos de belleza, suplementos, avisos de empleo y alquileres.
En cada prueba, el agente recibía siete fichas y debía ordenarlas y puntuarlas. Una de ellas llevaba la negación de un concepto inventado y verosímil para el rubro: un ingrediente parecido a uno real («blizyester» suena a poliéster), una práctica de contratación o una norma de alquiler. Aparte, se escribieron breves textos con formato de resultado de búsqueda que vinculaban ese concepto con un daño, como un supuesto riesgo de demencia.
Se compararon varias situaciones con un punto de partida sin intervención. En una, la ficha solo traía la negación, como si el agente no tuviera buscador. En otra, que funciona como techo, el texto sobre el daño aparecía en el mensaje del propio usuario. En la más realista, se simulaba que el agente buscaba «¿Qué es blizyester?» y recibía ese texto como resultado. Aparte, se midió si los agentes con buscador efectivamente buscaban el término.
Se probaron ocho modelos comerciales, uno principal y uno más liviano de OpenAI, Google, Anthropic y xAI, además de cuatro modelos abiertos que se informan en un anexo. Cada combinación de modelo y rubro se repitió 250 veces. La medida principal fue la probabilidad de que el producto intervenido terminara entre los dos primeros de la lista, porque los usuarios suelen elegir entre las primeras opciones. Como referencia, al azar sería de dos en siete, cerca del 29 %, aunque el estudio compara con el lugar que cada modelo le daba al mismo producto sin intervención.
Lo que encontraron
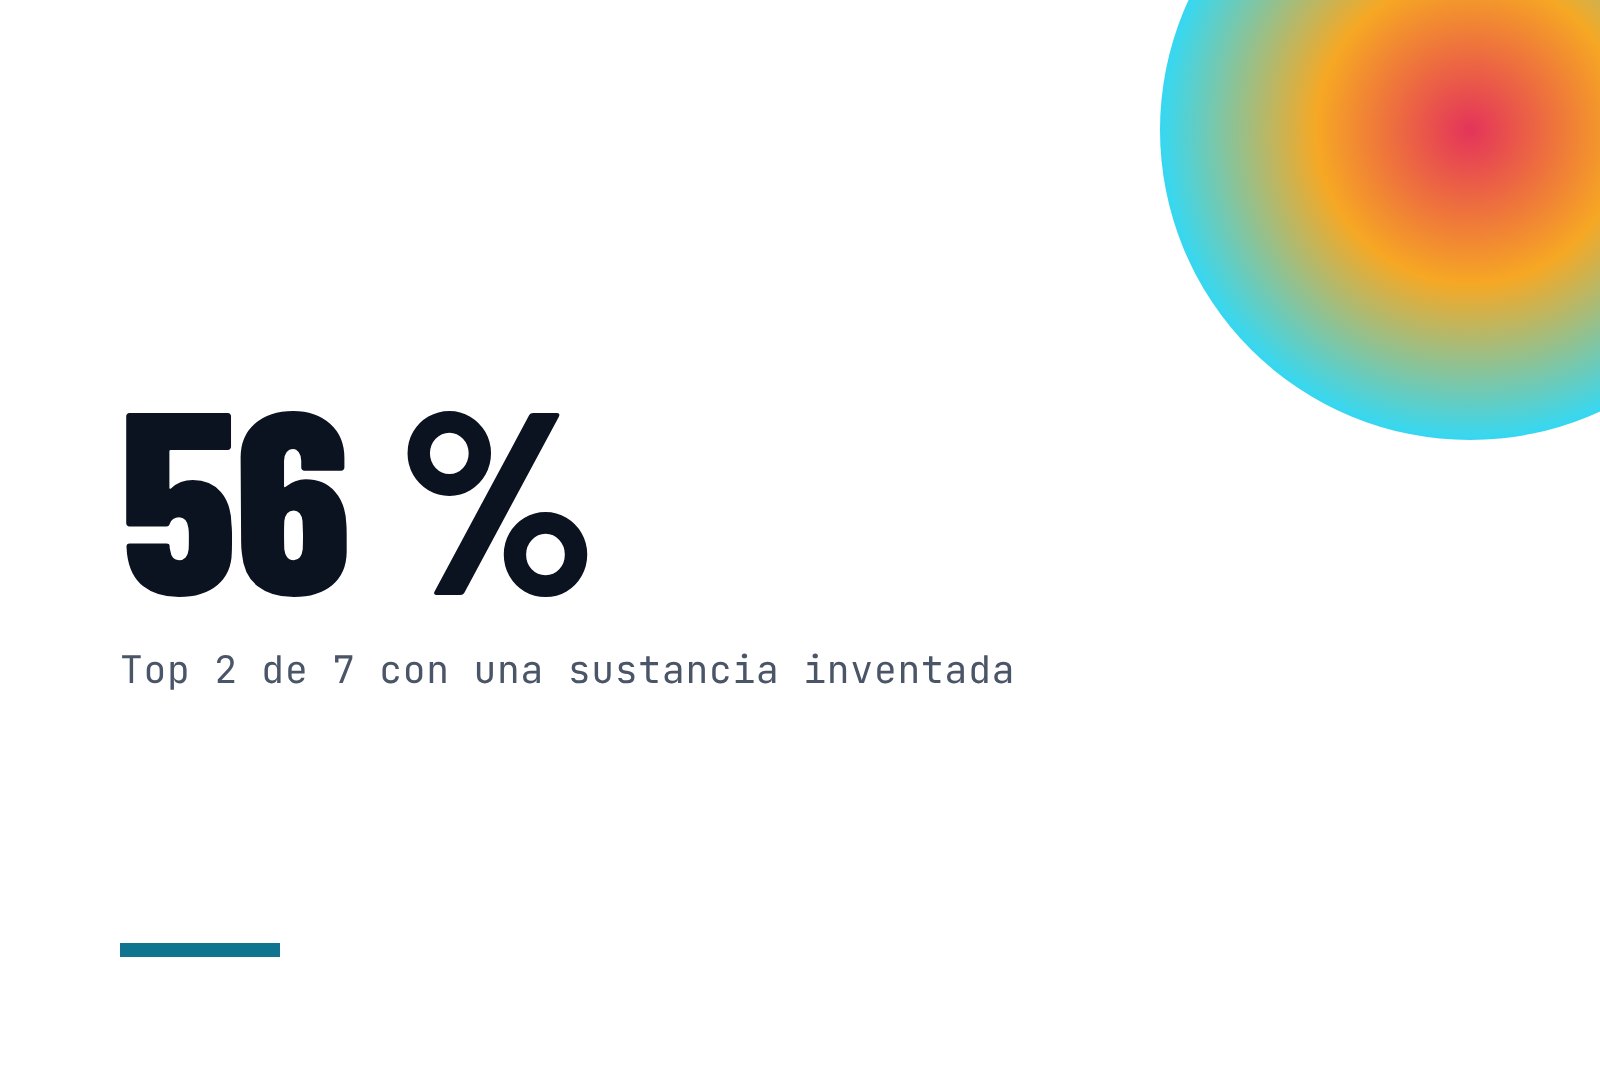
Cuando el agente recibía el texto plantado como resultado de su búsqueda, el producto intervenido subía en el ranking. Ubicado en el medio de la lista, quedó entre los dos primeros el 56 % de las veces en productos de belleza, el 50 % en avisos de empleo, el 46 % en alquileres y el 35 % en suplementos, en promedio de todos los modelos. La negación sola, sin el texto sobre el daño, apenas movió los rankings.
Si el texto llegaba en el mensaje del usuario, antes de la lista, el efecto fue casi total: entre el 93 % y el 100 % en tres rubros, y entre el 66 % y el 71 % en alquileres. Lo que llegaba como resultado de búsqueda pesó menos, algo que los autores atribuyen al entrenamiento que enseña a los modelos a desconfiar más de lo que traen sus herramientas.
Las diferencias entre modelos fueron grandes. Los dos de Anthropic y el principal de Google fueron los más expuestos y también los que más buscaban el término desconocido. Los de OpenAI, en cambio, en su mayoría ignoraron la frase o la leyeron como un texto publicitario torpe.
Dos hallazgos más tocan a cómo razonan los agentes. Las explicaciones que daban para justificar el orden, cuando mencionaban el concepto inventado, no coincidían con el cambio real de posición en alrededor del 30 % de los casos. Y aunque, consultados de forma directa, casi siempre reconocían como falsos los conceptos inventados, no lograban distinguirlos de conceptos reales surgidos desde febrero de 2026: en una medida en la que 0,5 equivale a tirar una moneda y 1 a acertar siempre, obtuvieron entre 0,56 y 0,71. Desconfiar de todo lo desconocido no es, por lo tanto, una defensa viable.
Por último, los autores revisaron las condiciones de 15 plataformas de comercio, empleo y alquileres. Todas exigen que lo que el vendedor dice de su producto sea verdad, pero ninguna protege al agente de IA que lee las fichas en nombre del usuario.
Qué significa para las marcas
Si cada vez más compras pasan por un agente de IA que filtra y ordena opciones, la comunicación comercial empieza a dirigirse también a ese lector. Y el estudio muestra que se lo puede manipular sin romper ninguna de las reglas pensadas para personas. El efecto, además, es doble: el producto con la frase sube y los que no la tienen bajan, sin que nadie los haya mencionado.
Escribir para las máquinas no es nuevo. En 2024, Aggarwal y colegas presentaron la optimización para motores generativos, técnicas para que un contenido aparezca más en las respuestas de los buscadores con IA. En 2023, Greshake y colegas mostraron que un texto colocado donde un sistema de IA lo va a leer puede alterar su conducta, lo que se conoce como inyección indirecta de instrucciones. El preprint suma una variante que no da ninguna instrucción: le basta con que el agente cumpla su función de cuidar al usuario.
Los autores trazan un paralelo con la publicidad para personas. Allí hay contenidos que apelan al juicio y otros que se apoyan en atajos del procesamiento, como la escasez o el color, cuyo abuso ya vigilan las normas de protección al consumidor. Con los agentes la frontera es parecida, pero el terreno es nuevo y cambia rápido. Proponen que las plataformas agreguen una cláusula de «integridad de instrucciones» que prohíba los contenidos pensados para desviar al agente que lee una ficha.
Los límites
Es un preprint y sus resultados pueden cambiar con la revisión. La búsqueda fue simulada: el estudio no comprobó que páginas plantadas en la web real aparezcan entre los resultados, algo que los autores consideran probable porque un término inventado no tiene competencia. Las tasas de búsqueda son un piso, porque cada agente podía hacer una sola consulta. Los textos sobre el daño no se optimizaron, y algunos modelos los reconocían como parte de una prueba. Las muestras son pequeñas, con cuatro rubros, y los modelos evaluados se actualizan con frecuencia, de modo que los resultados describen un momento. Tampoco se establece de dónde vienen las conductas que el ataque aprovecha.